LangChain Runtime 与上下文工程
代码仓库ChainReaction 写了几个 agent 之后,让人卡住的通常不是工具调用怎么写。麻烦的是”这次运行该拿到什么数据”:用户 ID 从哪来,上一轮对话的偏好存在哪,工具返回的 8000 字文档要不要整个塞回模型。这些问题在 create_agent 的入门示例里看不到,因为示例里只有一个 messages。 LangChain 把答案拆成了三块:state、context、store。名字都短,含义却经常被混着用。我见过把 user_id 塞进 state 的写法,也见过每次 invoke 都把数据库连接写进 messages 的写法。 这篇先把这三块拆开,再看 context_schema 和 runtime.context 怎么用,然后把 runtime 上剩下的字段挨个跑一遍。剩下的一节讲上下文工程:窗口怎么被填满,又该怎么打扫。 文中的输出都是在 Python 3.12 上跑 DeepSeek 得到的真实终端结果,脚本放在 Runtime/。 三个数据源官方文档在 context engineering 页面给了一张表,按作用域把三者分开了。我...
LangChain Structured Output
代码仓库ChainReaction 让模型输出一段文字,再用正则从里面抠字段,这活干一次就够了。字段多一个、模型换个说法、多写一句解释,正则就得重写。结构化输出解决的就是这件事:给模型一份 schema,等它跑完,你从 state 里取一个 Python 对象,sr.email 直接可用。 LangChain Agents 那篇里提过 ToolStrategy 和 ProviderStrategy,只有几句对比。这一篇换个角度,只看三件事:策略怎么选、失败时长什么样、拿不到结果时从哪儿查。代码在 DeepSeek、Ollama 云端的 OpenAI 兼容端点和原生端点上真实跑过,最后补上 Google Gemini,原生结构化输出总算跑出了正向结果。环境是 langchain 1.4.3、langchain-openai 1.6.7、langchain-ollama 1.1.0、langchain-google-genai 4.4.0、pydantic 2.13.5,脚本在仓库的 StructuredOutput/ 目录下。 一、structured_respons...
LangChain 短期记忆
代码仓库ChainReaction 找 LangChain 的记忆功能时,很多人会先去翻有没有一个叫 Memory 的类。v1 里没有这个东西。短期记忆就是 agent state 里的一份消息历史,加上你自己挂上去的字段,再交给 checkpointer 按 thread 存下来。把这三件事的分工弄清楚,后面大部分问题都能自己判断。 这篇先用最小例子跑通两轮对话,证明第二轮真的记得第一轮;然后解释 thread_id 和 checkpointer 的关系,以及换 thread 之后会发生什么;接着扩展自定义 state 字段,最后处理消息历史把上下文窗口撑爆的情况。文里的终端输出都是在 Windows 上连 DeepSeek 真跑出来的,脚本放在仓库的 ShortTermMemory/ 目录下。 顺带划一下短期和长期的分界。短期记忆活在一个 thread 里,thread 结束或者你换掉 thread_id,它就够不着了。跨会话记住用户偏好、历史结论,那是 long-term memory 的活,用的是另一套 Store 机制。这篇只谈 thread 内的部分。 ...
LangChain Streaming
代码仓库ChainReaction agent.invoke() 慢是个问题,比慢更难受的是沉默。一个带工具的 agent,一次提问背后至少两次模型调用和一次工具执行。DeepSeek 上这两次调用各要一两秒,工具再花点时间,用户盯着空白界面等五秒,然后一段完整回答突然出现。中间那五秒里 agent 其实一直在干活,只是没人告诉外面。 流式要解决的就是这五秒。它把过程中的事件提前暴露出来:模型开始吐第一个 token 了,它决定调哪个工具、参数是什么,工具返回了什么,第二次模型调用又开始了。这些事件本身就是产品体验的一部分,聊天界面里的”正在调用 get_weather”就是这么来的。 这篇讲清楚 LangChain 里流式的两层 API,以及它们各自适合放在哪。底层是 agent.stream() 和它的 stream_mode,你拿到的是按 mode 切分的事件;上层是 agent.stream_events(version="v3"),同一个运行被投影成几条独立的、带类型的流。读完你应该能判断该用哪一层,以及为什么自己的流式代码会重复打印同一段文字。...
LangChain Messages
代码仓库 ChainReaction 模型 API 是无状态的。服务端不留上下文,我们平时看到的”多轮对话”其实是客户端每次把完整历史重新输入一遍所呈现的。LangChain 里被传入的那份历史是一组消息对象。 工具调用走的是同一条路。模型说”调 get_weather,参数 Paris”,这是一条消息;工具函数执行完返回的 “Sunny, 22C”,是另一条消息;两条消息靠一个 ID 串起来。若是ID 不匹配,整个请求将会被拒绝。 消息不只是提示词的包装类,它是模型和工具之间唯一的数据载体。这件事决定了很多日常问题长什么样。请求报 400 多半是消息顺序或配对不合法;模型答非所问,大多是历史里混进了该清掉或是其他的内容;上下文超限,问题将变成该裁掉哪几条消息,该用哪种方法压缩。你没法直接改 HTTP body,能改的只有这串对象。 这篇文章将讲清四类消息的字段、工具调用的配对规则、content 和 content_blocks 的分工、元数据里能读到什么、怎么存怎么还原,以及长对话怎么裁剪。代码位置在 Messages/ 目录下。 12345678910from...

最长连续序列
题目给定一个未排序的整数数组 nums,找出数字连续的最长序列的长度。这里的”连续”不要求序列元素在原数组中相邻,并且题目要求时间复杂度为 O(n)。 示例 输入:nums = [100, 4, 200, 1, 3, 2] 输出:4 解释:最长连续序列是 [1, 2, 3, 4],长度为 4。它由原数组中的 1、3、2、4 四个数构成,顺序无关紧要。 思路先观察一下问题:我们要找的是”连续的数字段”。例如 1、2、3、4 是一段,100 单独是一段,200 单独是一段。数出一段有多长,本质上是在反复做一件事:判断某个数的下一个数在不在数组里。 如果每次判断都去数组里线性扫描,代价是 O(n),整体会到 O(n²)。为了把这个判断变成 O(1),先把全部数字放进一个哈希集合 unordered_set,它同时做了两件事: 去重。重复出现的数字不影响答案,集合天然去重。 让”判断 x 在不在”成为平均 O(1) 的查询。 集合建好后,遍历每个数 x: 如果 x - 1 已经在集合里,说明 x 不是某个连续段的开头,跳过它。因为这一段会由更小的那个开头去统计,不必重复劳动。 如果...
字母异位词分组
本文讲解字母异位词分组,利用排序后的字符串作为哈希键归类单词,给出C++代码、复杂度分析及字母计数优化思路。
Vibe Coding 产品研究
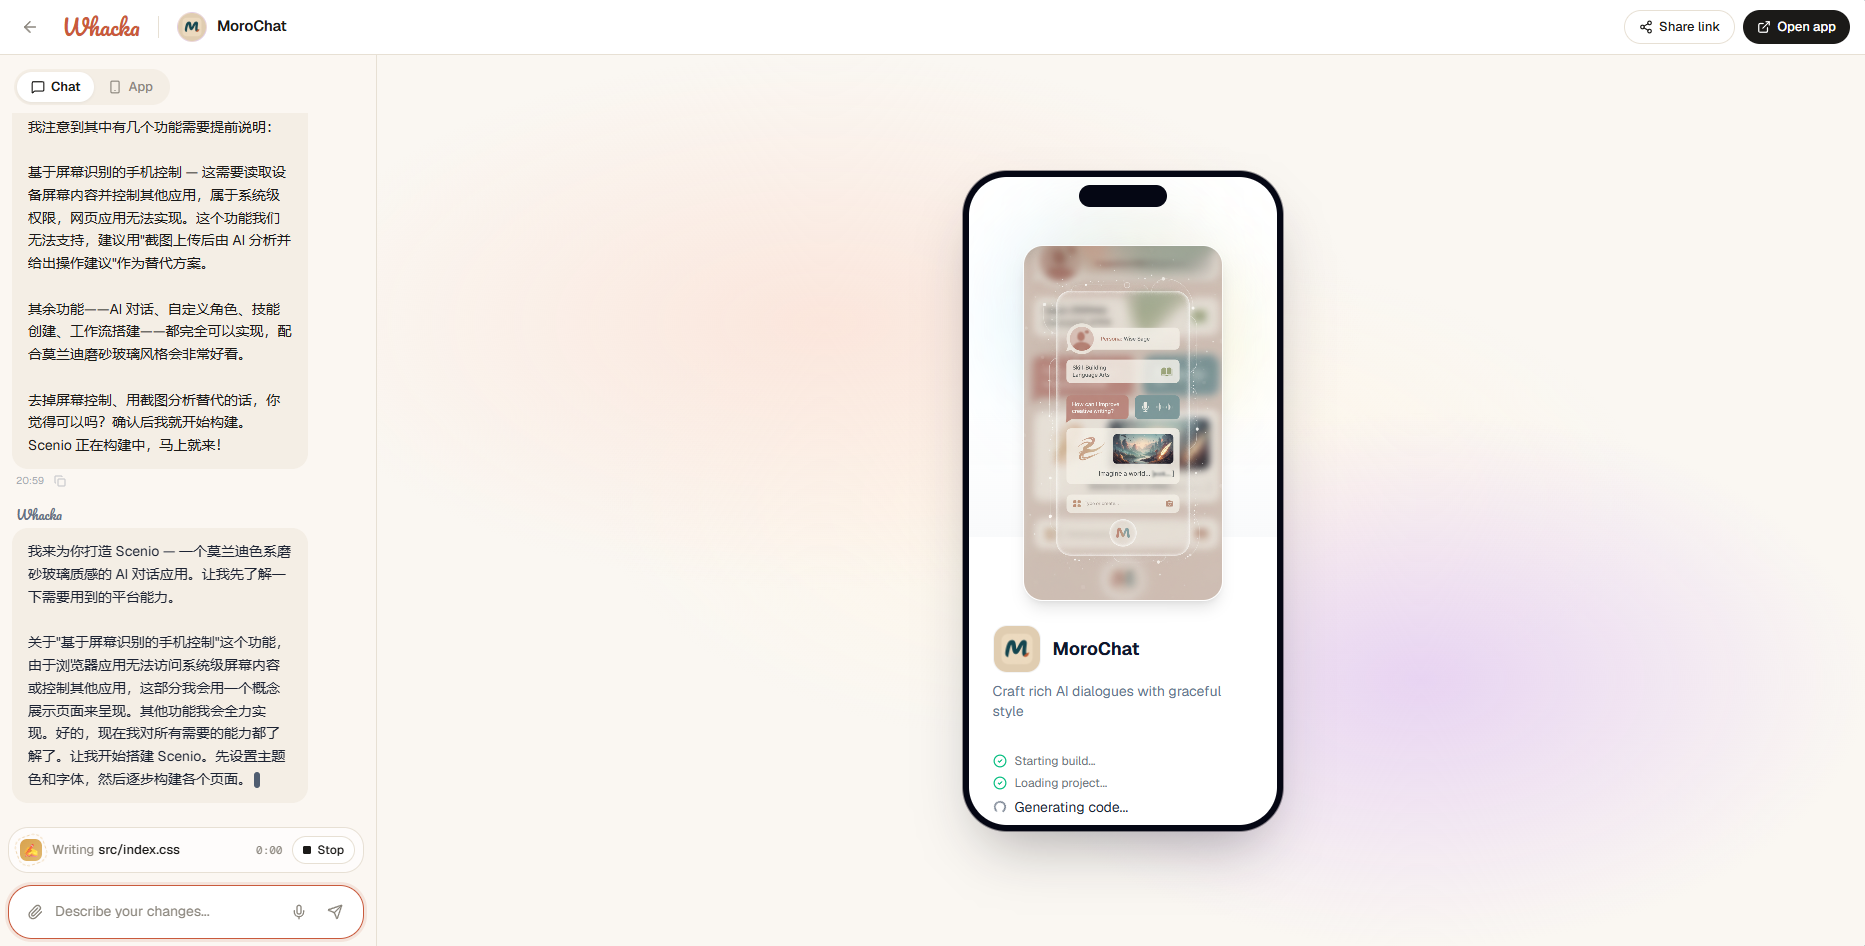
Vibe Coding是以自然语言驱动大模型生成代码的新型开发方式,开发者从编码转向需求描述与效果把关,典型流程包括描述意图、生成代码和验收迭代,工具分AI编辑器和云端全栈平台,适合快速原型但存在隐患。
模板元编程
模板元编程通过模板特化与递归实例化,将计算从运行期转移到编译期,实现零开销和类型安全。本文从起源到现代简化,全面拆解其核心原理与实战应用,助你从入门到掌握这一C++高级特性。
模板折叠与SFINAE模板替换
本文解析C++17模板折叠与SFINAE的原理、语法及实际应用,通过示例展示二者结合编写简洁高效泛型代码的方法,并补充相关细节。